
P-04
Direto ao Ponto
Assistente de IA que só responde com fonte, com custo travado em quatro camadas.
Chat público e gratuito que explica uma mudança constitucional na jornada de trabalho. As respostas saem de uma base de 37 fichas verificadas no git, com citação obrigatória e o status de cada regra. O site e a API rodam num Cloudflare Worker, sobre Supabase com RLS em todas as tabelas, cotas atômicas no Postgres e um painel que opera tudo sem deploy.
- cloudflare
- supabase
- postgres
- rls
- rag
- llm
- streaming
- astro
- rate-limiting
- lgpd
01Visão geral
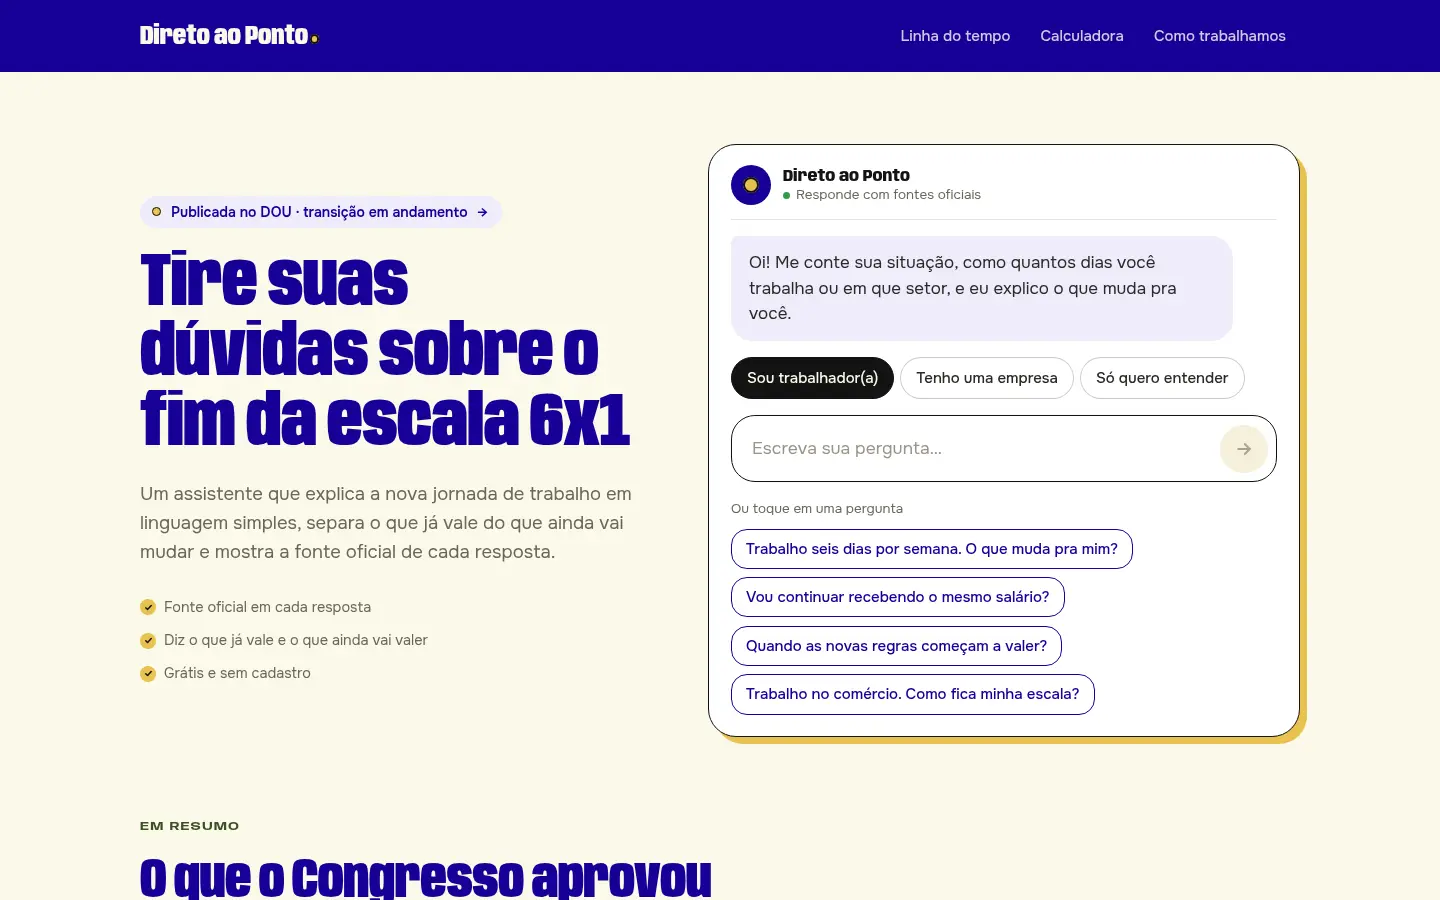
O Direto ao Ponto é uma plataforma pública e gratuita que explica, em linguagem simples, o fim da escala 6x1 e a transição para a nova jornada de trabalho no Brasil. O centro da experiência é um chat com IA: a pessoa diz se é trabalhadora, se tem uma empresa ou se só quer entender, faz a pergunta e recebe uma resposta curta, com a fonte oficial de cada afirmação e uma indicação clara do que já vale, do que foi aprovado mas ainda não vale e do que depende de negociação ou de regra futura.
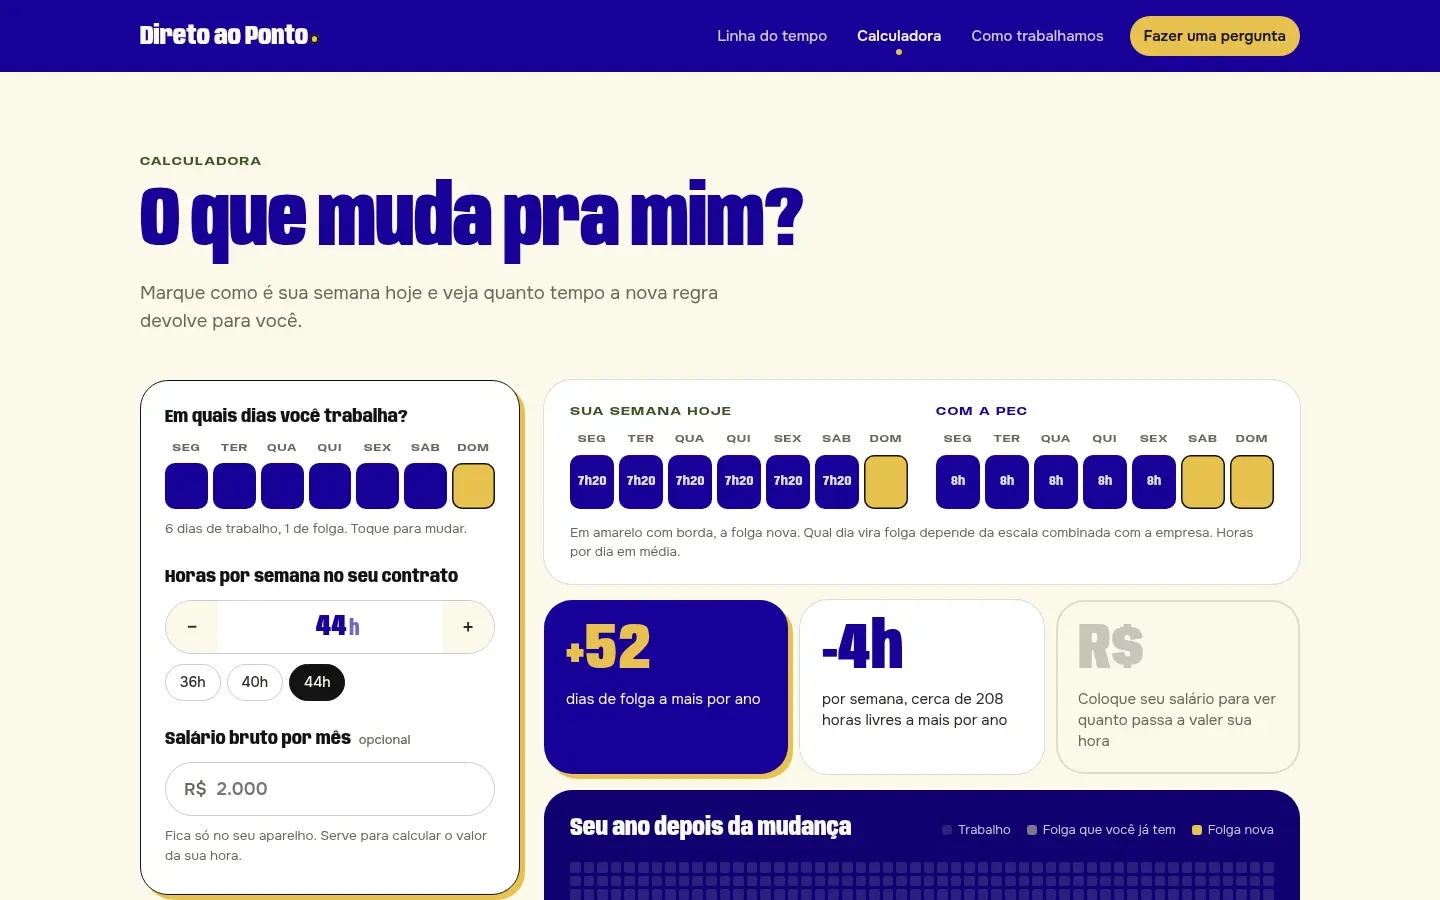
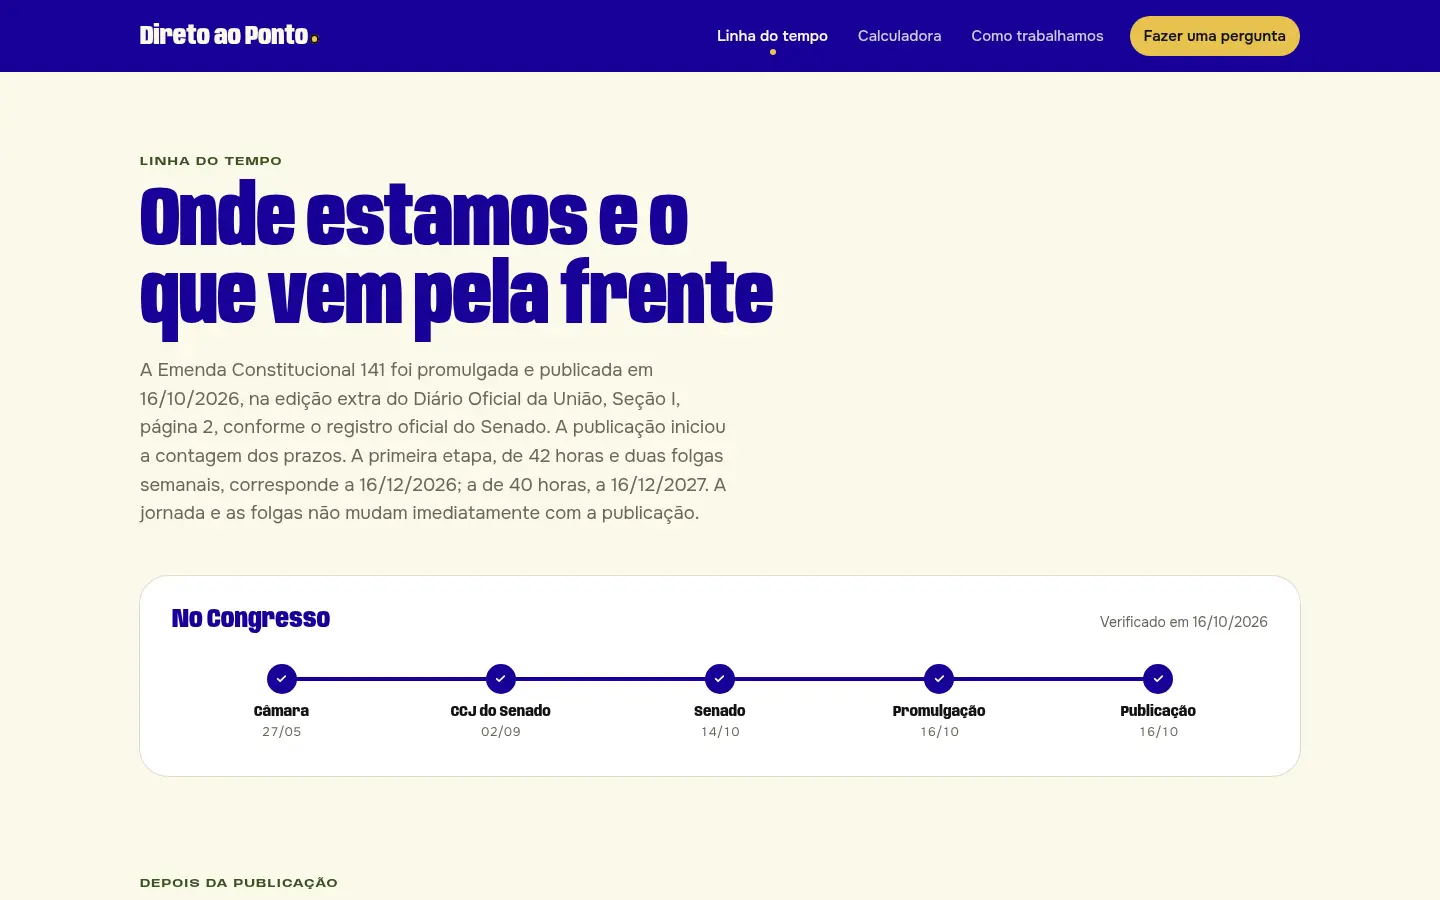
Em volta do chat há uma calculadora ("O que muda pra mim?"), em que as contas são feitas por código e não pela IA, uma linha do tempo da tramitação e uma página que explica o método editorial. O mesmo chat também pode ser embutido em outros sites por um único arquivo JavaScript.
Por trás da interface há um back-end pensado para um serviço aberto à internet: cada resposta é limitada a uma base de conhecimento revisada, o gasto com IA tem teto em quatro camadas e uma equipe pequena opera tudo por um painel, sem precisar de deploy.
02O problema
- Mudanças na lei trabalhista geram uma onda de dúvidas práticas ("meu salário vai diminuir?", "quando começa?", "e para doméstica?"), e a informação circula misturando texto aprovado, propostas alternativas, estimativas e opinião.
- Um chatbot genérico piora isso: inventa prazos, arredonda números e apresenta como lei em vigor o que ainda está em transição.
- Um chat público com IA também é um alvo: qualquer pessoa pode disparar milhares de perguntas e transformar curiosidade em fatura.
- A equipe precisava atualizar o conteúdo no ritmo dos acontecimentos (a promulgação e a publicação aconteceram durante o desenvolvimento) sem reescrever o sistema.
03A solução
- Base de conhecimento versionada no git: 37 fichas em Markdown, uma por fato, cada uma com status (em vigor, aprovado, com data prevista, depende de negociação, em debate, estimativa), fontes e data de atualização; 47 fontes catalogadas. Um script valida tudo no build e falha se uma ficha cita fonte inexistente ou não tem status.
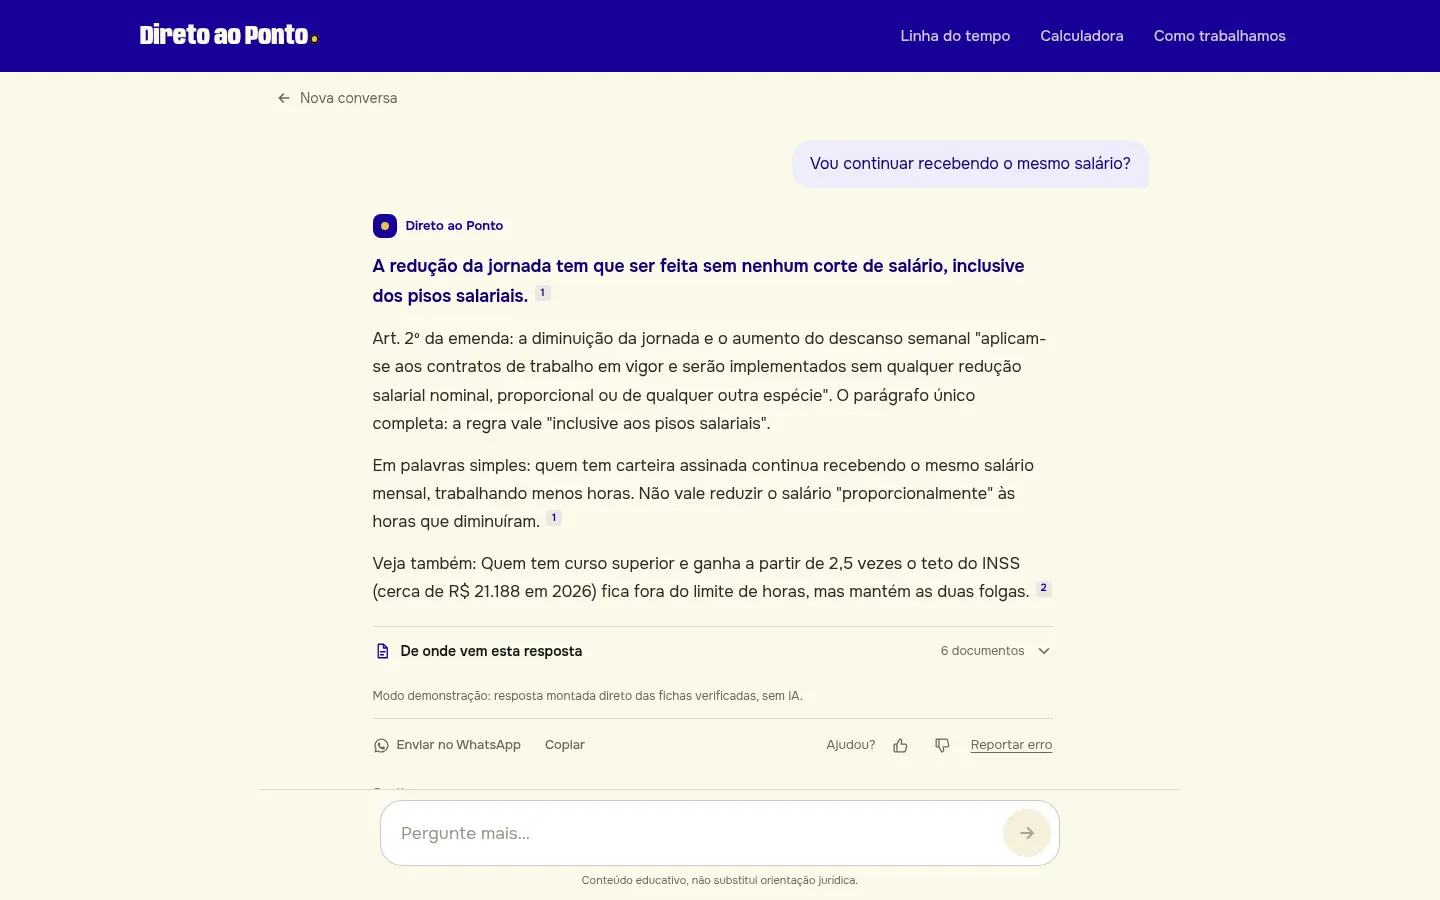
- Chat com citação obrigatória: o modelo cita fichas por ID (
[[salario-mantido]]); o front transforma cada ID em referência numerada com link para a fonte. O modelo nunca escreve links: todo link vem das fichas. - Respostas enriquecidas: o modelo escreve Markdown enxuto e blocos (
:::cards,:::numeros,:::linha-do-tempo,:::estudo,:::atencao…) que um parser próprio, tolerante a texto incompleto, converte em componentes durante o streaming. - Perfis: trabalhador, empresa ou "só quero entender", que mudam o enfoque sem quebrar o cache do prompt.
- Modo demonstração: sem chave de IA, ou com o interruptor ligado no painel, o chat responde montando trechos das fichas por busca de termos, sem custo.
- Calculadora de dias de folga, horas e valor da hora, feita por código determinístico.
- Widget embutível:
npm run widgetgera um único.js(Preact + fichas públicas, ~25 KB gzip segundo o README) que outro site monta num<div data-chat-6x1>. - Painel administrativo com seis abas: saldo da conta de IA, uso e custo, conversas, feedback, operação (modelo, kill switch, modo demo, RAG, cotas, tamanho da resposta) e gestão de admins.
- RAG pronto e medido, desligado por decisão: busca híbrida em pgvector disponível com um clique, mantida desligada enquanto a base inteira cabe no prompt em cache.
- Banco fechado: RLS em todas as tabelas, grants revogados de anon/authenticated e 9 policies só para admin
- Custo com teto em quatro camadas: rate limit nativo, cota diária atômica no Postgres (fail-closed), limite de crédito na chave e kill switch no painel
- Prompt de ~25 mil tokens estável byte a byte para cache: US$ 0,0006 a 0,0011 por resposta medido em produção
- Citação obrigatória: o modelo nunca escreve links; todo link vem de fichas versionadas no git
- RAG híbrido (pgvector + FTS + RRF) medido com recall 22/22 e mantido desligado por decisão de engenharia
- Remoção de admin com efeito imediato: o Worker revalida o papel atual a cada pedido, além do JWT
04Arquitetura
Ler o diagrama como lista (14 componentes, 16 conexões)
Componentes
- Clientes: Navegador<br>site Astro + Preact, Widget embutido<br>sites parceiros, CORS por allowlist, Painel /admin<br>login OTP por e-mail
- Cloudflare Worker: site + API na mesma origem: Static assets<br>dist/ do Astro, /api/chat · /api/feedback<br>/api/saude · /api/admin/*, Rate limit nativo<br>20 perguntas/min por hash de IP, kb.json embutido no build<br>37 fichas + prompt cacheável, Cron horário<br>saldo + alerta, Workers AI<br>bge-m3 embeddings
- Supabase: Postgres + pgvector + pg_cron<br>RLS em todas as tabelas, consumir_cota()<br>cota diária por pessoa e global, Supabase Auth<br>signup fechado · app_metadata.role
Conexões
- Navegador<br>site Astro + Preact → Static assets<br>dist/ do Astro
- Navegador<br>site Astro + Preact → /api/chat · /api/feedback<br>/api/saude · /api/admin/* (POST, texto em streaming)
- Widget embutido<br>sites parceiros, CORS por allowlist → /api/chat · /api/feedback<br>/api/saude · /api/admin/* (POST, texto em streaming)
- Painel /admin<br>login OTP por e-mail → /api/chat · /api/feedback<br>/api/saude · /api/admin/* (JWT Bearer)
- Painel /admin<br>login OTP por e-mail → Postgres + pgvector + pg_cron<br>RLS em todas as tabelas (leitura via PostgREST + RLS)
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → Rate limit nativo<br>20 perguntas/min por hash de IP
- Rate limit nativo<br>20 perguntas/min por hash de IP → consumir_cota()<br>cota diária por pessoa e global
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → kb.json embutido no build<br>37 fichas + prompt cacheável
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → Workers AI<br>bge-m3 embeddings (modo RAG opcional)
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → Postgres + pgvector + pg_cron<br>RLS em todas as tabelas (chave secreta)
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → OpenRouter<br>Claude Haiku com prompt cache (SSE)
- /api/chat · /api/feedback<br>/api/saude · /api/admin/* → Supabase Auth<br>signup fechado · app_metadata.role (getClaims + papel atual)
- Cron horário<br>saldo + alerta → OpenRouter<br>Claude Haiku com prompt cache (/credits)
- Cron horário<br>saldo + alerta → Postgres + pgvector + pg_cron<br>RLS em todas as tabelas
- kb/ no git<br>fonte da verdade editorial → kb.json embutido no build<br>37 fichas + prompt cacheável (build-kb)
- kb/ no git<br>fonte da verdade editorial → Postgres + pgvector + pg_cron<br>RLS em todas as tabelas (sincronizar-kb: embeddings só do que mudou)
Decisões que moldam o desenho:
- Site e API no mesmo Worker. O
wrangler.tomlusarun_worker_first = ["/api/*"]: páginas saem direto do cache de assets e só a API executa código. Mesma origem, sem CORS para o site principal. - O prompt vem do build, não do banco. O Worker usa o mesmo
kb.jsonque o site usa para montar as citações. O modelo nunca recebe uma ficha que o front não conhece; o banco guarda uma cópia para busca, métricas, cotas e configuração. - O git manda, o banco é cópia. Conteúdo editorial nunca é editado no Postgres.
sincronizar-kb.mjsrecalcula embeddings só das fichas que mudaram.
05Por dentro
- Cloudflare Worker em TypeScript (
src/worker/, 16 módulos): roteamento, chat, cotas, validação, feedback, admin, gestão de admins, catálogo de modelos, cliente OpenRouter com parser SSE próprio, RAG e coleta de saldo. - 12 rotas de API: 4 públicas (
/api/chat,/api/feedback,/api/saude,/api/config-publica) e 8 administrativas (/api/admin/eu,openrouter,saldo/coletar,config,modelos,adminsGET/POST,admins/remover). - Streaming de ponta a ponta: o Worker consome o SSE do OpenRouter e reemite texto puro por um
TransformStream. O registro da conversa (tokens, cache, custo real, latência, fichas citadas × recuperadas, motivo de parada) é gravado emctx.waitUntil, depois que a resposta já foi entregue. - Postgres no Supabase: 6 migrations, 8 tabelas (
fontes,fichas,kb_meta,feedback,conversas_log,cotas,config,saldo_openrouter), 4 views comsecurity_invoker(uso_diario,recusas_diarias,fichas_uso,conversas_painel) e 3 jobspg_cronde retenção. - RAG híbrido:
fichas.embedding vector(1024)com índice HNSW por cosseno,tsvectorem português com índice GIN e a funçãobuscar_fichasque funde as duas listas por RRF. Embeddings com@cf/baai/bge-m3(multilíngue) pelo binding de Workers AI, sem fornecedor novo. A consulta usa as duas últimas perguntas, para cobrir perguntas de seguimento. - Configuração viva: a tabela
config(jsonb) guarda modelo, kill switch, cotas e limites. Cada isolate do Worker mantém cópia por 30 s; uma mudança no painel vale em até 30 segundos em todos os servidores, sem deploy. - Prompt cacheado: instruções + todas as fichas formam um
systemestável marcado comcache_control: ephemeral, com o provedor fixado na Anthropic (allow_fallbacks: false). Data, perfil e origem vão no fim da última mensagem, nunca nosystem, para não invalidar o cache.
- Astro 7 + Preact 11, páginas estáticas (início com chat, calculadora, linha do tempo, método, 404, admin) e ilhas interativas.
- Parser de respostas (
src/lib/formato.ts, com testes) que interpreta Markdown e blocos em tempo real durante o streaming e é tolerante a sintaxe incompleta. Tudo é renderizado como JSX; não háinnerHTMLnemdangerouslySetInnerHTMLno código. - Sistema visual próprio com tokens, View Transitions entre páginas e animações que respeitam
prefers-reduced-motion. - Painel admin em Preact, autenticado com Supabase Auth (OTP de 8 dígitos por e-mail), lendo dados direto pelo PostgREST sob RLS e escrevendo apenas pelo Worker.
- Widget (
src/widget/) empacotado num único arquivo; o visual é do site hospedeiro (classescx-*), o JS só gera o HTML.
- Cloudflare Workers com static assets, Rate Limiting binding, Workers AI binding, Cron Trigger horário,
version_metadata(a versão aparece em/api/saude) e observability ligada. - Supabase gerenciado (região São Paulo) com pgvector e pg_cron; ambiente local completo com
supabase start(Docker) e Mailpit para os e-mails de login. - Deploy:
supabase db push→ sincronização da base →wrangler deploy→ teste de contrato contra produção. Ordem documentada para quando fichas são criadas ou removidas, porque o front só reconhece citações que estavam no build. - Rollback em três níveis:
wrangler rollbackpara o Worker, modo demonstração ou kill switch no painel para só o chat, e migrations aditivas com instruções de reversão. - Simulador do OpenRouter (
scripts/testes/mock-openrouter.mjs) para testar o modo IA localmente, inclusive erros 402/429/5xx, sem gastar.
06Segurança
8 ataques considerados, 8 defesas em produção.
Pular a interface e falar direto com o banco ou a API, com a chave pública na mão.
Ler conversas ou feedback direto pela API do banco com a chave pública
RLS em todas as tabelas, grants revogados de anon/authenticated; só admins (app_metadata.role) leem, e a matriz de acesso é testada por script
Quem tem algum acesso tentando ganhar mais: virar admin, ler o que não deve, manter acesso revogado.
Continuar no painel depois de ter o acesso de admin removido
Além de validar o JWT pelo JWKS, o Worker consulta o papel atual do usuário a cada pedido; signup público fechado e papel só em app_metadata
CSRF, webhooks falsos, tokens reaproveitados, links assinados e redirecionamento aberto.
Chamar a API do chat a partir de um site qualquer
CORS só para uma allowlist de origens que embutem o widget; o resto da API é mesma origem
XSS, iframe, fórmula em CSV, upload disfarçado e manipulação do prompt da IA.
Enviar payload gigante ou histórico forjado para manipular o prompt
Leitura do corpo com teto de bytes real (413), pergunta de até 1.000 caracteres, janela de 12 mensagens, marcadores de protocolo removidos, perfil e origem por allowlist
Fazer o modelo injetar links ou HTML na página
O modelo cita só IDs de fichas; links vêm da base versionada e a resposta é renderizada como componentes JSX, sem innerHTML
Estourar a fatura, esgotar limites, inundar logs e derrubar funções com carga.
Disparar milhares de perguntas para estourar a fatura de IA
Rate limit nativo de 20/min, cota diária por pessoa e global checada no Postgres antes de chamar o modelo (fail-closed), limite de crédito na chave e kill switch
Enumerar quem está na base, raspar dados pessoais, ligar perguntas a pessoas, extrair segredos.
Rastrear quem perguntou o quê a partir dos logs
IP nunca gravado: cotas usam sha256(IP + dia + sal); o log de conversas não tem IP nem ID de sessão e é apagado em 90 dias por pg_cron
Mexer em contagens, apagar a base, editar o histórico ou negar o que foi autorizado.
Admin comprometido gravar configuração arbitrária ou um modelo inexistente
Validadores tipados com faixas na escrita e de novo na leitura; troca de modelo só para IDs do catálogo; grant de update restrito a colunas
Modelo de acesso: o público nunca fala com o banco.
- RLS ligado em todas as tabelas. A migration base revoga todos os grants de
anoneauthenticatede concede explicitamente só aoservice_role, usado apenas pelo Worker. - Admins são usuários do Supabase Auth com
app_metadata.role = 'admin'. A funçãoeh_admin()lê o papel do JWT;app_metadatasó é gravado pelo servidor (nuncauser_metadata, que o próprio usuário pode alterar). - 9 policies, todas condicionadas a
eh_admin(): leitura de 8 tabelas e update daconfig, com grant limitado às colunasvalor,atualizado_emeatualizado_por(admin não troca a chave de configuração, não insere feedback, não apaga ficha). - As funções
consumir_cotaebuscar_fichastêmEXECUTErevogado depublic/anon/authenticated; todas usamsecurity invokeresearch_path = ''. - Views criadas com
security_invoker = true, para que a RLS das tabelas de origem valha também nelas. scripts/testes/acesso-banco.shverifica uma matriz anônimo × usuário comum × admin em 12 objetos pelo PostgREST, além de signup fechado e chamadas de RPC.
Autenticação do painel.
- Login sem senha: código OTP de 8 dígitos com expiração de 600 s; signup público desligado; a tela mostra a mesma mensagem para qualquer e-mail, sem revelar quem é admin.
- O Worker valida o JWT com
auth.getClaims()(assinatura ES256 conferida pelo JWKS), exigeaud = authenticatede o papel de admin e, como o token vale até 1 h, consulta o papel atual do usuário pela Admin API a cada pedido: uma remoção de admin vale na hora para tudo que passa pelo Worker. - Ninguém remove o próprio acesso e o último admin não pode ser removido.
Custo e abuso: teto em quatro camadas.
- Rate limit nativo da Cloudflare: 20 perguntas e 30 feedbacks por minuto por pessoa.
- Cota diária por pessoa (padrão 150) e global (padrão 5.000) no Postgres, com uma única instrução atômica (
insert … on conflict do update … returning contagem <= limite), checada antes de chamar o modelo. - Limite de crédito na própria chave do OpenRouter.
- Kill switch e modo demonstração no painel, sem deploy.
A cota é fail-closed: se o banco não responde, o chat recusa com 429 em vez de gastar sem controle. O rate limit por minuto falha aberto de propósito, porque a camada do Postgres continua valendo.
Privacidade (LGPD).
- A "pessoa" nas cotas é
sha256(IP + dia + sal): o IP nunca é gravado e o identificador muda todo dia. Girar o sal zera as cotas. conversas_logguarda a pergunta sem IP, sem identificador de pessoa ou de sessão, por 90 dias (pg_cron); cotas por 30 dias; snapshots de saldo por 1 ano.- Na calculadora, o salário digitado fica só no navegador.
Validação e hardening da API.
- Corpo lido em streaming com limite de bytes, que não confia só no
content-length(50 KB no chat, 16 KB no feedback, 2–4 KB no admin); 413 quando passa. - Validação estrita do histórico: papéis permitidos, pergunta de até 1.000 caracteres, janela de 12 mensagens que sempre começa pelo usuário, respostas anteriores limpas de marcadores de protocolo e cortadas em 4.000 caracteres. Perfil e origem só entram se estiverem numa allowlist.
- Toda escrita de configuração passa por validadores tipados com faixas (
max_tokens500–8000,rag_top_k3–15…); a troca de modelo só aceita IDs existentes no catálogo do OpenRouter. A configuração lida do banco é validada de novo antes do uso. - CORS apenas para uma allowlist de origens (sites que embutem o widget) em
/api/chate/api/feedback. - Cabeçalhos:
X-Content-Type-Options: nosniff,X-Frame-Options: DENY,Referrer-Policy,Permissions-Policysem câmera, microfone e geolocalização;/admincomnoindexeno-store.
Segredos. Chave do OpenRouter com limite de crédito; uma chave de gestão separada, só para ler saldo e criada com expiração; chave secreta do Supabase só como secret do Worker. Os procedimentos de rotação estão documentados. No wrangler.toml só há valores públicos por definição.
Segurança do conteúdo. O modelo responde apenas com base nas fichas, com regras explícitas de neutralidade e de separação entre fato, estimativa e opinião. Links vêm só das fichas e a renderização é feita por componentes, sem HTML do modelo. A bateria avaliar.mjs (29 casos) checa citações esperadas e padrões proibidos, inclusive uma pergunta de recomendação de voto, que precisa ser recusada.
07Desafios técnicos
Streaming que chegava de uma vez só
Com compressão, a Cloudflare e o runtime local seguravam o texto inteiro até o fim, e a resposta "aparecia pronta". A solução foi responder /api/chat com cache-control: no-store, no-transform e content-encoding: identity, além de usar um parser SSE próprio que reemite texto puro.
Custo previsível com um prompt de ~25 mil tokens
Enviar a base inteira em cada pergunta seria caro sem cache, e qualquer variação no system quebra o cache. O prompt foi desenhado para ser byte a byte estável (data, perfil e origem vão na última mensagem), com o provedor fixado para garantir o cache. O custo medido em produção ficou em US$ 0,0006 a 0,0011 por resposta com cache. O painel mostra o percentual de respostas com cache para detectar regressões.
Respostas cortadas pelo raciocínio do modelo
Respostas com blocos (cards, tabela, linha do tempo) terminavam no meio. O conversas_log mostrou parada = 'length': os tokens de raciocínio contam no mesmo max_tokens. O limite virou configuração do painel e foi para 6.000 por migration, e o log passou a registrar tokens_raciocinio.
RAG: medir antes de ligar
A infraestrutura de busca híbrida foi construída e avaliada (recall de 22/22 com top-7 em 22 casos), mas ficou desligada: com 37 fichas a base inteira cabe no prompt em cache e não há risco de a busca perder a ficha certa. A medição revelou um caso de paráfrase que a fusão RRF empurra para fora do top-7, registrado como critério antes de ligar. Se a busca ou o embedding falharem, o Worker cai para a base inteira.
08Resultados
- 16 commits entre 15/10/2026 e 21/10/2026: do MVP ao back-end em Workers, à atualização após a promulgação e ao widget embutível.
- Em produção na Cloudflare, com o modelo configurável pelo painel sem deploy.
- Custo medido de US$ 0,0006 a 0,0011 por resposta com cache (~US$ 0,0035 quando o cache precisa ser escrito), segundo a documentação de operação de 15/10/2026.
- Recall da busca híbrida: 22/22 nos casos de avaliação (top-7).
- 37 testes unitários (parser de respostas, SSE, validação, publicação), teste de contrato HTTP, teste de cotas e matriz de acesso ao banco.
- 16
- commits
- 15/10 → 21/10/2026
- período
- 6
- migrations
- 8 / 4
- tabelas / views
- 9
- policies RLS
- 3
- jobs pg_cron
- 12
- rotas de API
- 37 / 47
- fichas / fontes
- 37
- testes unitários
- 29
- casos de avaliação
- 22/22
- recall RAG (top-7)
- US$ 0,0006–0,0011
- custo por resposta
- 5.739
- linhas TS/TSX
- 2.603 / 2.067 / 558
- linhas Astro/CSS/SQL
como medimos
git log --oneline | wc -l (HEAD 5c317d4)
como medimos
datas do primeiro e do último commit no git log
como medimos
supabase/migrations/ em HEAD
como medimos
create table / create view nas migrations
como medimos
create policy nas migrations (8 admin_le + 1 admin_edita)
como medimos
cron.schedule em 20261015190000_operacao.sql
como medimos
src/worker/index.ts e src/worker/admin.ts (4 públicas + 8 admin)
como medimos
node scripts/build-kb.mjs --check
como medimos
test()/it() em *.test.ts no commit HEAD
como medimos
array CASOS em scripts/avaliar.mjs
como medimos
docs/backend/RAG.md, medição de 15/10/2026
como medimos
docs/backend/OPERACAO.md, medido em produção em 15/10/2026 (com cache)
como medimos
wc -l em HEAD: .ts 2.634 (30 arquivos) + .tsx 3.105 (16), sem tipos gerados
como medimos
wc -l em HEAD; SQL só das migrations
09Linha do tempo
- 15 out 2026
MVP: site, chat e base de conhecimento
- 16 out 2026
Back-end em Cloudflare Workers: chat, RAG com pgvector, painel admin e operação
- 16 out 2026
Dossiê de fontes da base de conhecimento
- 16 out 2026
Conteúdo atualizado com a promulgação da emenda
- 16 out 2026
Respostas enriquecidas: Markdown e blocos viram componentes
- 16 out 2026
Max_tokens 6000 após diagnosticar cortes por tokens de raciocínio
- 21 out 2026
Chat embutível em sites parceiros
10Stack
- Astro 7
- Preact 11
- TypeScript
- CSS com tokens
- View Transitions
- Cloudflare Workers
- TypeScript
- SSE streaming
- Cron Triggers
- Rate Limiting binding
- Supabase Postgres
- pgvector (HNSW)
- Full-text search (portuguese)
- pg_cron
- PostgREST
- Cloudflare Workers static assets
- Supabase gerenciado
- Wrangler
- Supabase CLI
- Docker (local)
- Row Level Security
- Supabase Auth OTP
- JWT via JWKS
- Cotas atômicas em Postgres
- IP hasheado com sal diário
- Retenção via pg_cron
- CORS por allowlist
- OpenRouter
- Claude Haiku
- Prompt caching
- Workers AI bge-m3
- RAG híbrido (RRF)
11Ficha técnica
- type
- assistente público de IA
- stack
- Astro · Preact · CF Workers
- db
- Postgres + pgvector (RLS em tudo)
- auth
- Supabase OTP · app_metadata.role
- ai
- Claude Haiku · cache de prompt · RAG híbrido
- guard
- teto de custo em 4 camadas · fail-closed
- deploy
- wrangler deploy · borda
- status
- em produção
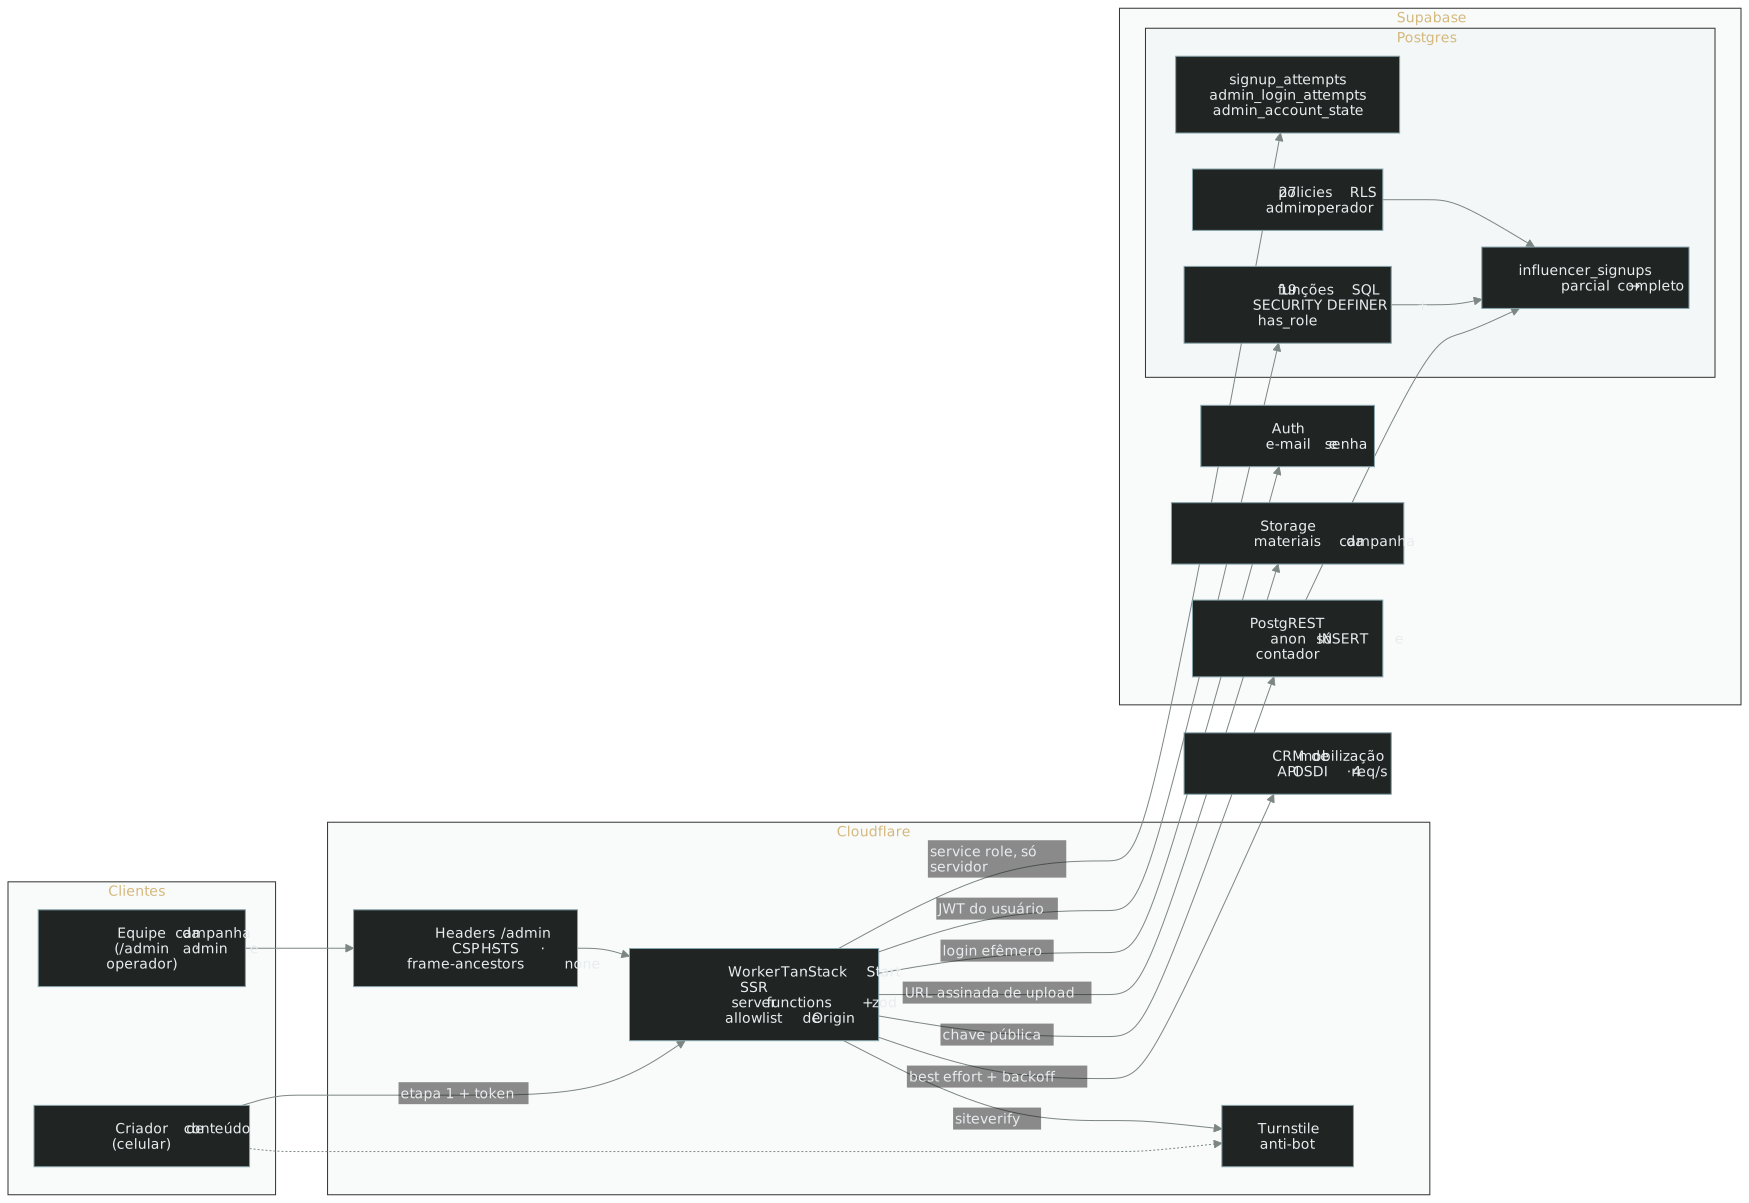
A plataforma que pôs milhares de criadores de conteúdo na campanha pelo fim das bets: cadastro nacional, contador público à prova de inflação e painel blindado contra força bruta.
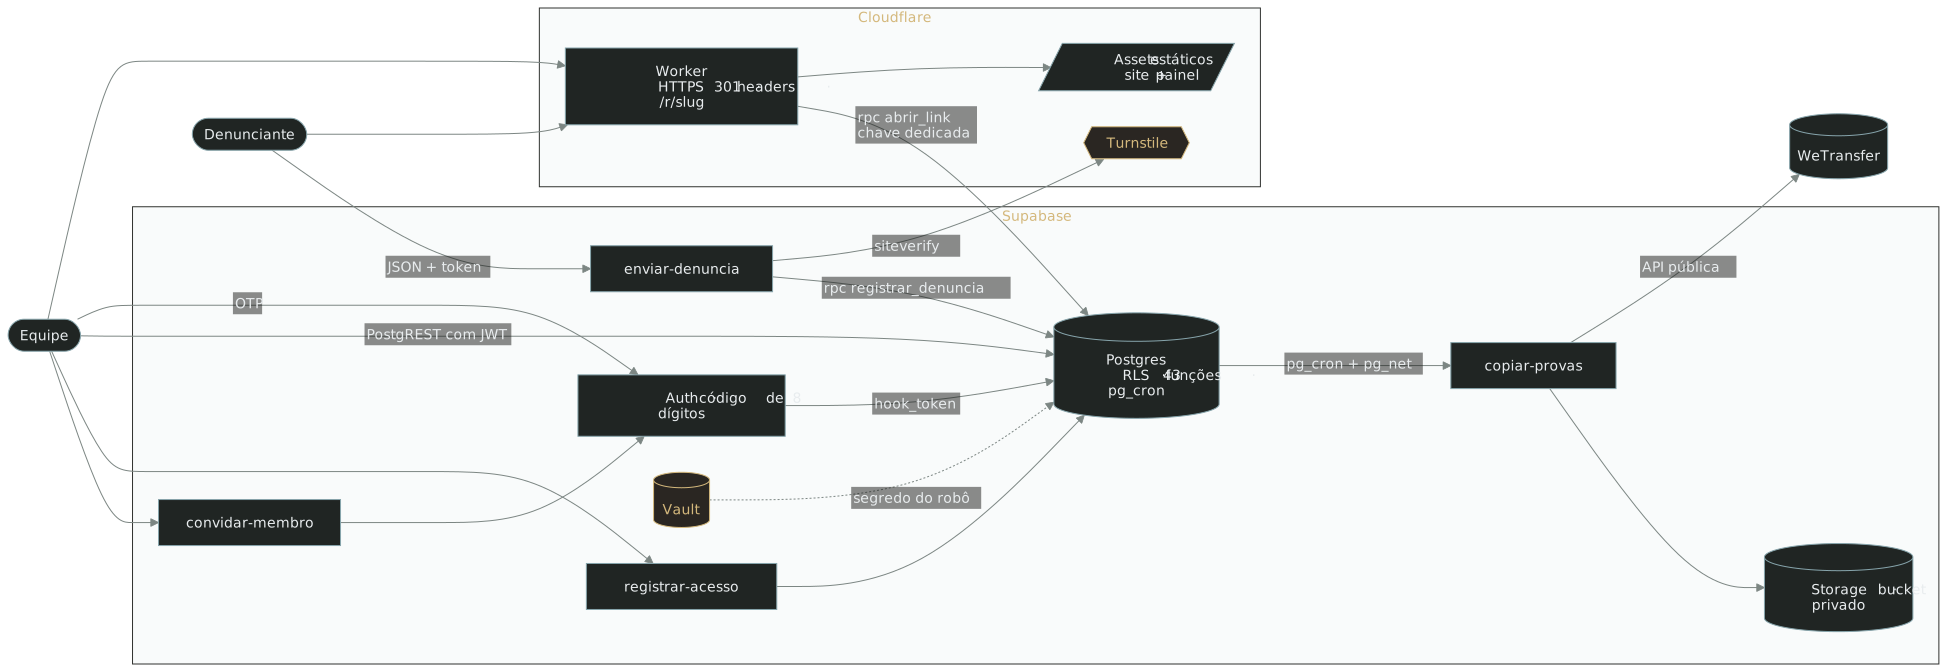
Canal público de denúncias com painel de triagem onde a autorização mora no banco: RLS por papel, contatos só por função auditada, sessão revogada na hora e robô que salva provas antes de expirarem.
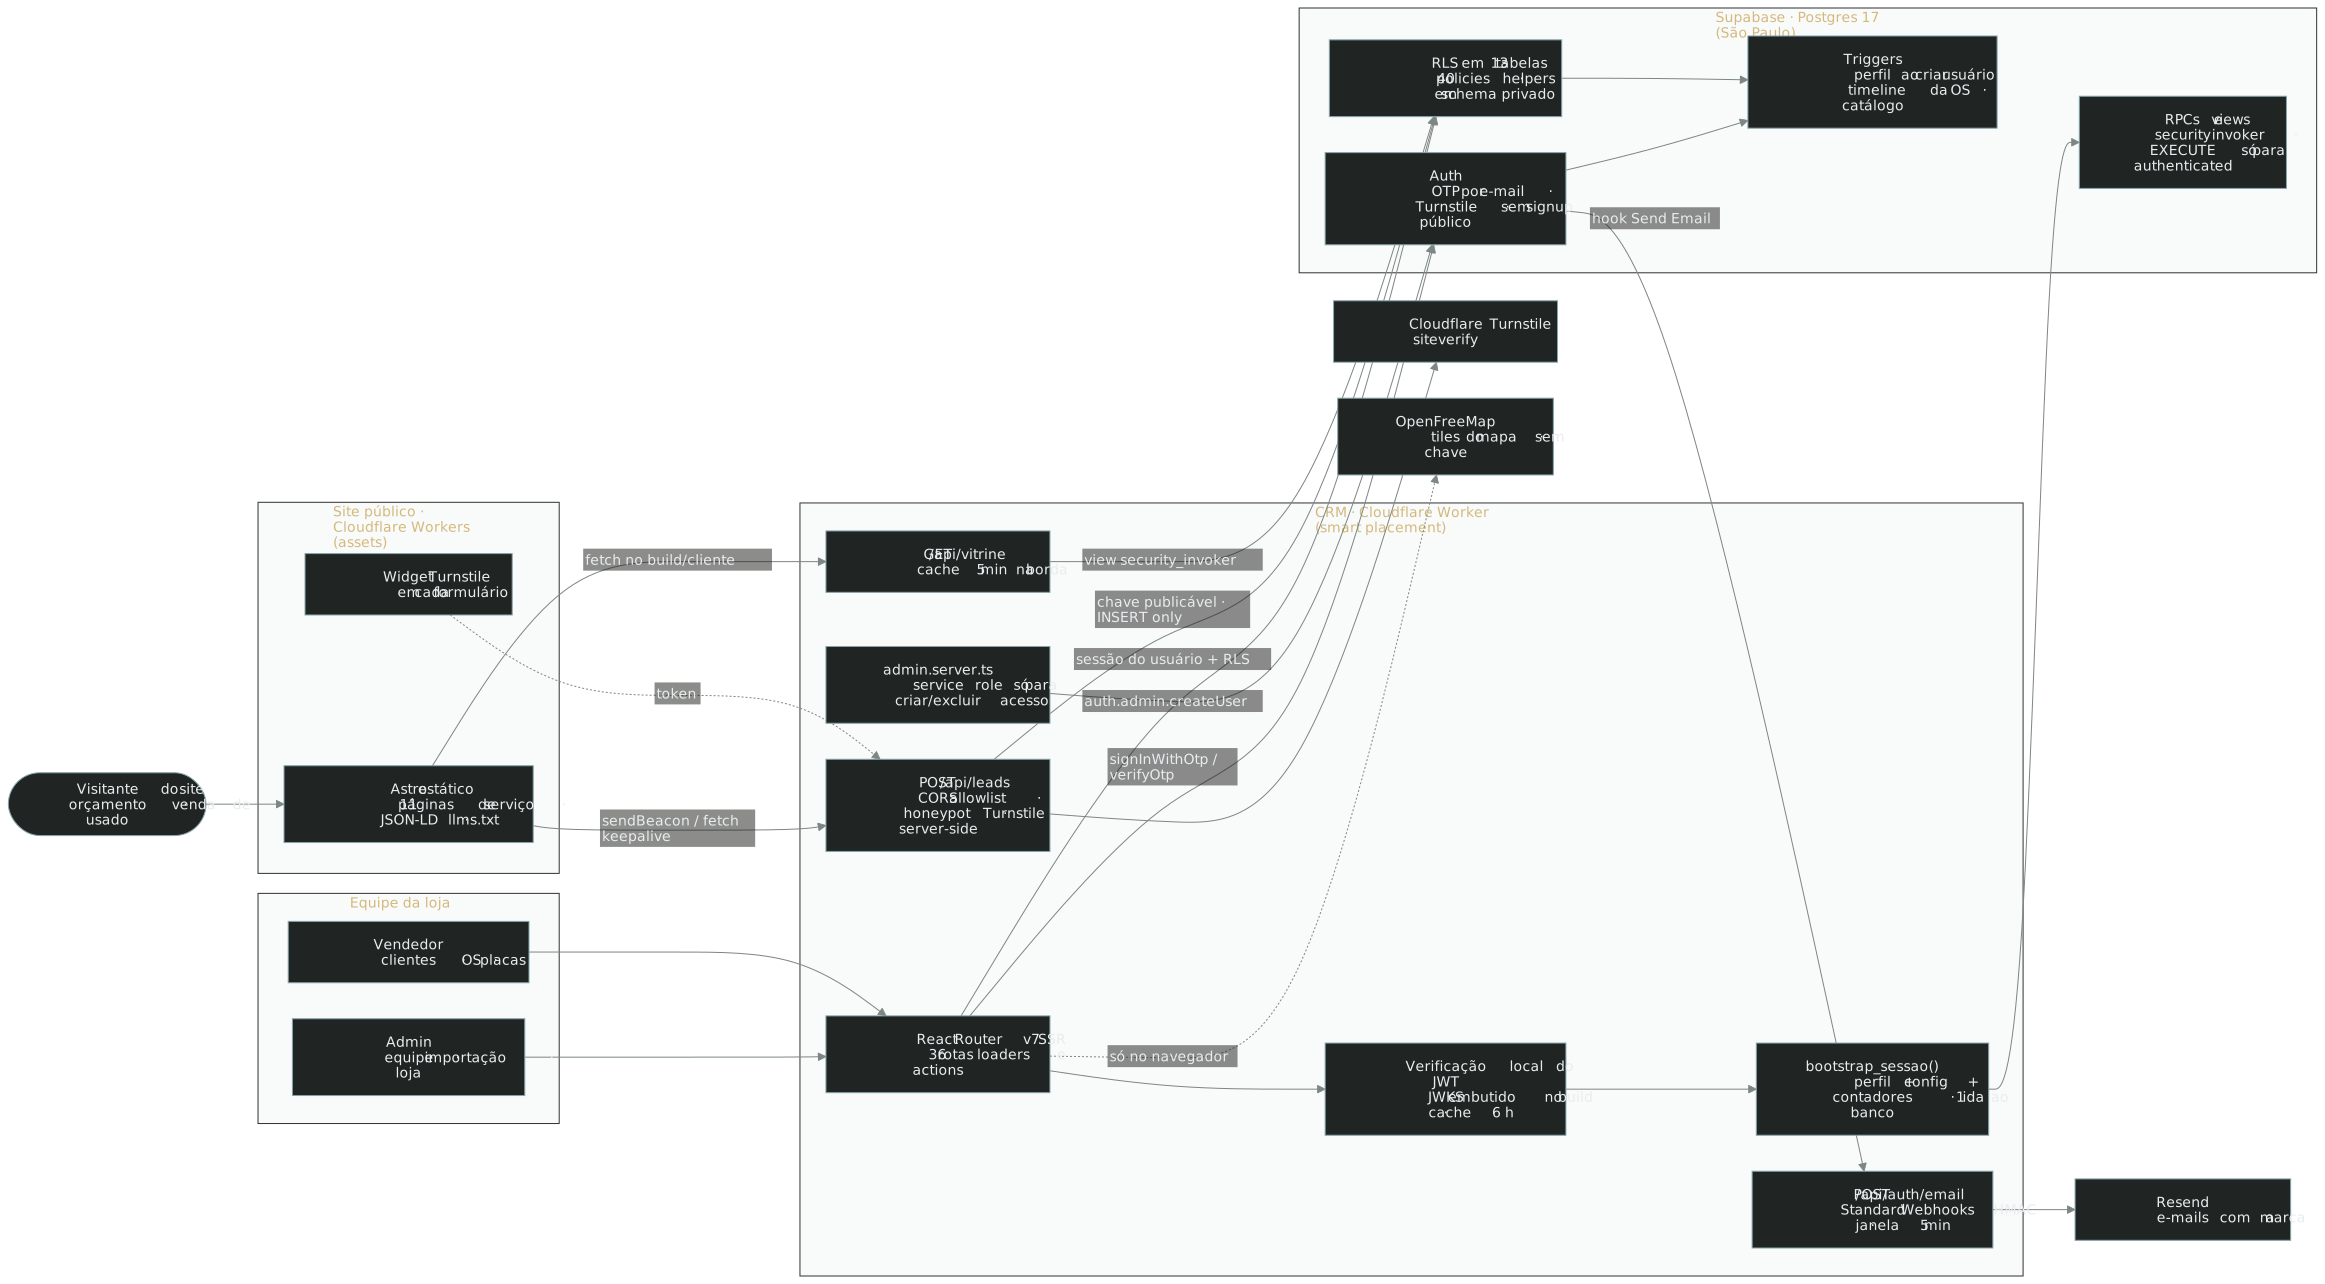
CRM e site de uma assistência técnica: clientes, ordens de serviço, placas de preço e vitrine, rodando na borda com RLS como última palavra.
Quer um sistema assim para a sua operação?
A Node projeta, constrói e protege plataformas sob medida para campanhas, mandatos e movimentos.
TECNOLOGIA E INTELIGÊNCIA POLÍTICA
© 2026 NODE. Todos os direitos reservados.